「集成测试要不要打桩」大概是测试团队里最容易反复吵、又最难吵出结论的问题。有人说必须全真,打桩就不叫集成测试;有人说外部服务不稳定,不打桩 CI 永远红;还有人干脆按依赖归谁所有划线:自己写的连真,第三方的全打掉。
争到后面,大家其实在争一个被跳过的前提:这条测试究竟想证明什么。把这个前提写清楚,答案往往自己就出来了。
一、真正要的不是 mock,是隔离
「mock」这个词容易把注意力引到工具上:用哪个库、怎么替换、要不要验证调用次数。但设计测试时想要的东西更朴素——隔离:让这条测试只检查我们关心的那部分行为,不被其他不受控因素干扰。
从最小的单元测试看最清楚。给计算器的加法写一条测试:无论这个计算器是手机应用、网页还是 API,1 + 2 都应该等于 3。这条测试默认外部世界不会影响这段代码的结果,这就是隔离。
如果被测代码确实有一个会影响行为的依赖,而我们既不能控制它、也不想控制它,就只剩两个选择:把两者放在一起测,或者把依赖替换掉。替换的目的仍然是回到最初那件事——让测试只检查我们想检查的行为。换句话说,隔离是目标,打桩只是达到目标的一种手段。
带着这个定义再看集成测试,问题就不是「该不该打桩」,而是「在这条测试里,哪一段行为算我们要证明的对象」。
二、同一个接口,两种目的,两种写法
看一个有外部依赖的接口:查询某本书在指定币种下的价格,价格由实时汇率服务换算得来。
| |
依赖很明显:它调用了另一个 API。要不要打掉?取决于这次想证明什么。
如果目标是「整条链路协同工作」——我们的接口确实能连上汇率服务、把返回的币种和价格正确带回来——那就让它们一起跑:
| |
注意断言只能写到 price > 0:真实汇率会变,没法断言一个具体数值。这就是连真要付的代价——结果不确定,断言必须放宽。
如果目标是「换算逻辑本身正确」——给定某个汇率,价格是否按预期算出——那就把依赖固定住:
| |
书价 12 美元,汇率固定为 0.5,于是可以精确断言 6.00。把两段测试并排看,最有意思的细节是连测试名都变了:一个叫「欧元价格从汇率服务返回」,一个叫「按当前汇率换算」。名字不是装饰,它把这条测试要证明的东西说清楚了。
所以顺序是:先设计「要检查什么」,再决定要不要隔离,最后让测试名、断言和这个决定保持一致。反过来做——先挑一个打桩策略,再往里塞断言——就会得到一堆看着整齐、却谁也说不清在保护什么的用例。
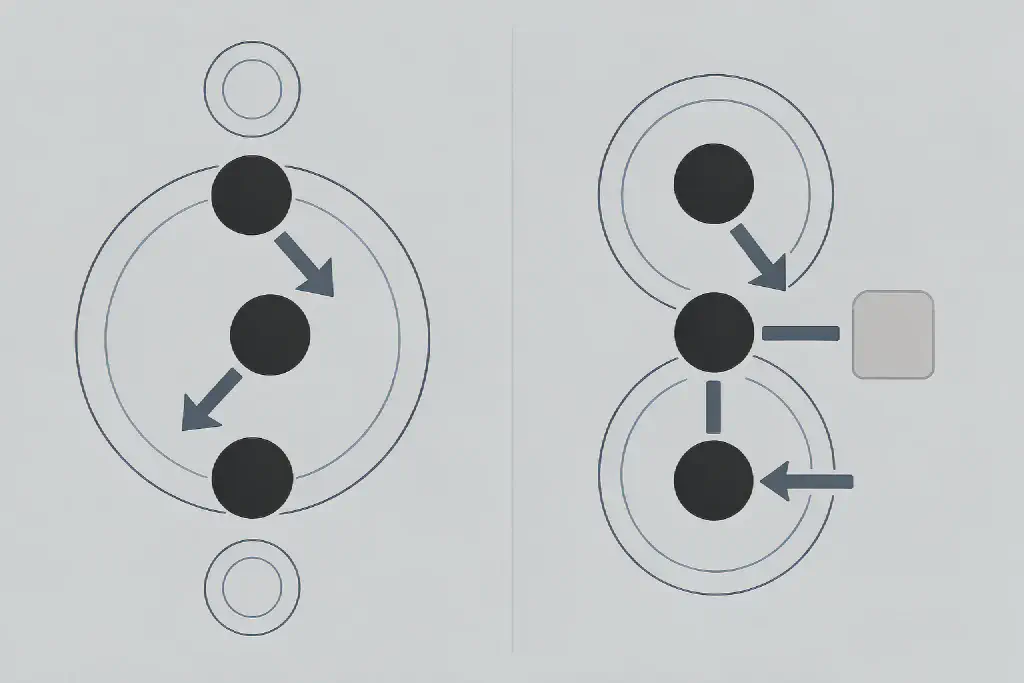
同一段接口代码,按「链路协同」与「换算逻辑」两种目的,分别走向连真与隔离两种写法
三、一张能拿去开会的判断表
依赖本身的特征确实会影响选择,但它是第二顺位的依据。常见的倾向是:不属于自己团队的第三方 API、响应慢、调用要花钱、结果不稳定、有副作用,这些更适合被隔离。原因不是「第三方不可信」,而是我们无法保证它在每次运行时表现一致,而测试需要可重复。
但这条经验有明确的例外,而且例外正好是集成测试这个名字的由来:当集成本身就是被测对象时,必须连真。参数拼错了、超时没处理、返回结构变了、鉴权头没带上——这些问题只在真实调用里出现,把依赖打掉之后,它们从测试视野里彻底消失。
可以把它压成一张按序执行的判断表:
- 第一步,用一句话写出这条测试要证明的行为,写不出就先别写代码。
- 第二步,问这个行为是否包含「与外部依赖正确协作」;包含就连真,不包含就隔离。
- 第三步,若连真,确认依赖在 CI 里可用、结果是否可重复、断言该放宽到什么程度、失败时能否区分是己方还是对方的问题。
- 第四步,若隔离,确认替换的边界在哪一层、固定值从哪来、是否覆盖异常返回而只覆盖成功路径。
- 第五步,让测试名、断言强度与上述决定对齐;名字含糊就重写。
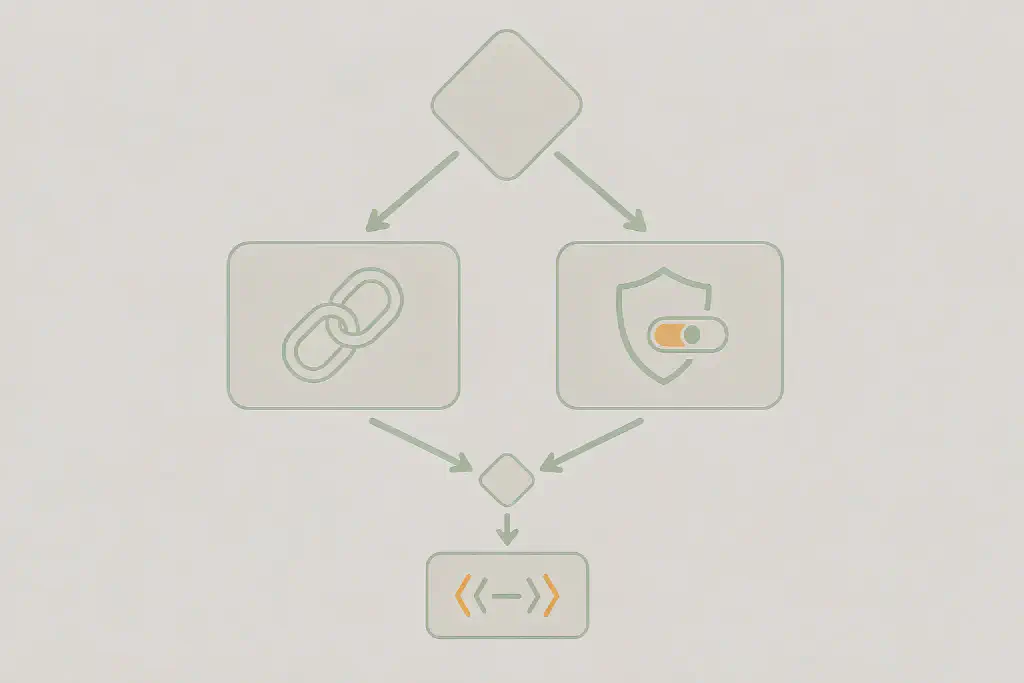
先定「要证明什么」,再判断被测行为是否包含协作,最后才落到连真或隔离的实现选择
四、四个常见的反模式
按「依赖归谁」一刀切。 把「自己写的连真、别人的打掉」当规则,会在两个方向上同时出错:自己的模块之间也可能有不该被真实调用的重依赖,第三方接口也可能正是这次要验证的集成点。归谁所有不携带关于测试目的的信息。
为了跑得快,把整条链路都打掉。 这是集成测试最常见的退化:每个外部调用都被替换,最后只剩下框架路由和一段内存里的计算,实际上变成了一条写得很重的单元测试。绿灯很快,但「服务之间能不能对得上」这个真正的问题一次也没被回答。
只断言桩被调用,不断言结果。 验证 get_rate 被以 EUR 调用了一次,能证明代码走过了那行,却不能证明价格算对了。桩的调用记录适合作为辅助证据,不适合作为唯一断言——它把测试绑在了实现细节上,重构一下就红。
测试名、断言与策略互相矛盾。 名字写着「与汇率服务集成」,实现里却把汇率写死;或者名字写着「换算正确」,断言却是 price > 0。这类不一致不会让测试失败,但会让后来读的人对这条用例的可靠性作出错误判断,比缺一条测试更伤。
五、把决策交给 AI 之前,先把决策写清楚
现在生成测试已经很容易。同一个接口,模型既能给出带桩的版本,也能给出连真的版本,两个版本通常都能跑绿。
问题恰恰在这里:前面整段讨论都建立在「我们知道自己要检查什么」之上,而模型并不知道。它只能从代码和提示里推断,推断不出来就按自己的偏好选一种。于是团队拿到的不是「我们决定的隔离边界」,而是「模型替我们做的默认选择」——而且这个选择被包在一段看起来很专业的代码里,评审时极难察觉。
要让它真正可用,提示里至少要把三件事说明白:
- 被测行为:这条测试要证明的是链路协同,还是换算逻辑,或者其他。
- 隔离边界:哪些依赖必须真实调用,哪些必须固定,固定的取值从哪来。
- 断言依据:期望值为什么是这个数,连真时允许放宽到什么程度。
把这三句写进提示,再让模型生成两种版本、由人来挑,效率会高很多;不写,就等着拿到一份「替你决定好了」的代码。工具能替我们写测试,不能替我们承担选择的后果。
六、结语
争论「集成测试该不该 mock」之所以没有终点,是因为它把一个设计问题当成了一个工具问题。隔离所要服务的目标始终只有一个:让测试明确地检查某一件我们真正在意的事。
先写下那件事,再决定边界,最后让测试名和断言替这个决定作证。做到这一点,用不用桩、用哪个库、AI 生成还是手写,都只是实现细节。