代码的生产成本塌了。曾经要反复斟酌才动笔的东西,现在一句话就能批量产出。但能生成和能发布是两件事:需求是否真被实现、这次变更会不会波及别处、我们凭什么相信一个 成功 的结果——这些判断反而变稀缺了。它们一直是测试与质量工程的地盘,只是载体从手工执行换成了别的东西。
下面不谈岗位存亡,给一套能直接搬进日常的做法。
一、先把三个默认前提拿去验一验
代码变多 ≠ 测试岗位变多。 工作量上涨时,雇主的选择不止招人:给现有团队配工具、把验证责任分散到整个工程团队,都能消化增量。质量问题会变多是真的,但「由和今天一样的角色与团队结构来消化」是一个大得多的假设。
shift left 是让验证更早发生,不是让测试更早参会。 真正做成的团队盯结果指标:多少缺陷流到生产、一次交付要多久,而不是「有没有 QA 团队」这个前提。开发者承担验证、observability 替代人工交接,都是成立的路径。
「自动化没取代我们,所以这次也一样」是预测,不是证据。 自动化确实没消灭测试,可工具、挑战和做法几乎全换了一遍;职业活过技术变迁,不等于工作内容照旧。一个让人安心的判断,理应和其他假设接受同样强度的审视。
二、把工作切成 generation 与 verification
这是最值得先动手的一步。生成侧让 coding agent 读入工单、文档、工程规约和 skill file,产出一个功能;但它上下文窗口有限、会犯错,有时连工单里明写着的要求都会漏掉。
验证侧换一个模型、另起一个 review agent,只做四件事:
- 需求是否被完整实现
- 工程规约是否被遵守
- 有无功能缺陷与安全问题
- 这次改动的
blast radius:两行代码可能波及仓库别处,甚至打断另一个关联仓库
关键在于两个上下文、两个模型。让生成它的那个 agent 顺手自查,等于没有校验——它对自己漏掉的那半条需求不会有异议。
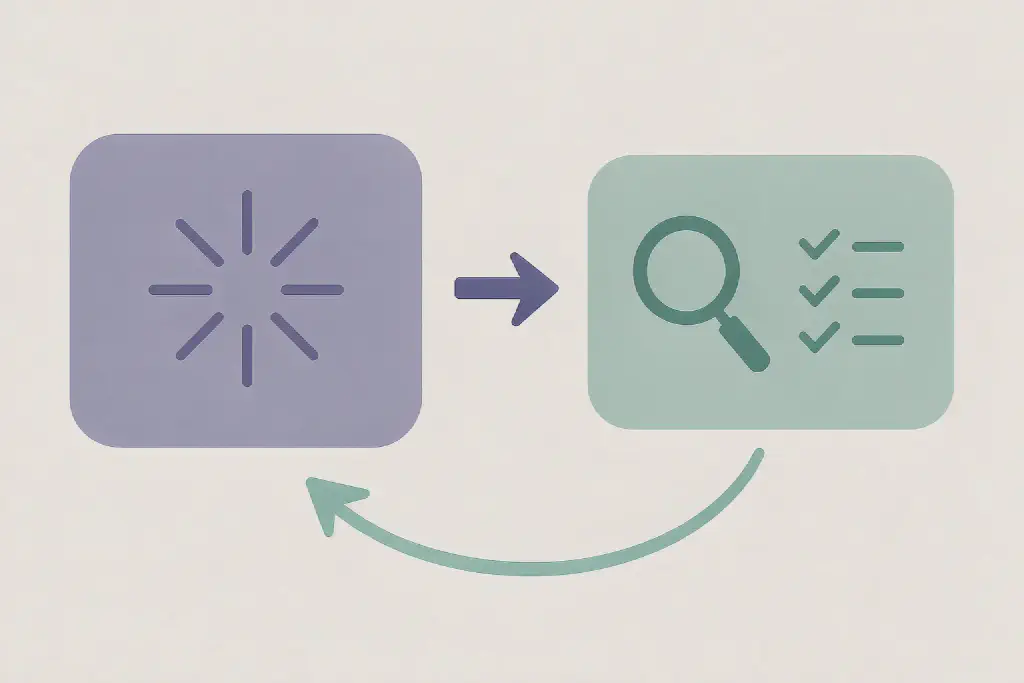
把生成与验证拆给不同的上下文与模型,评审侧独立检查需求完整性、规约遵循、缺陷与影响半径
三、没有自动化测试时,还有哪些信号
做个思想实验:假设 E2E 套件全部消失,但 AI 能力还在,靠什么判断一次变更能不能发布?可用的信号比想象中多:
- 类型检查、静态检查与构建结果
- 代码评审、提交历史、相关联的仓库
- 工单、需求、文档与设计稿
- 合规检查、工程规约、智能体技能文件
它们能暴露需求缺口、回归和规约偏离,让 agent 去梳理,完全可以在跑第一条端到端测试之前就给出判断。这提醒我们一件事:自动化测试是众多信号里的一种,不该是唯一一种。
四、把同一套评审一路往前挪
只在 pull request 阶段评审,反馈环还是太宽——代码写完了,返工成本已经发生。同一套检查可以逐级前移:
- 工单阶段:需求与现有代码库是否对得上,还没动手就能发现理解偏差
- 实现计划阶段:计划本身是否与需求自洽
- 未提交的本地改动:提交之前就发现偏差
- 合并请求阶段:检查实现与规约
等测试真正跑起来,这次变更已经过了好几道检查,反馈更早、要推倒重来的更少。
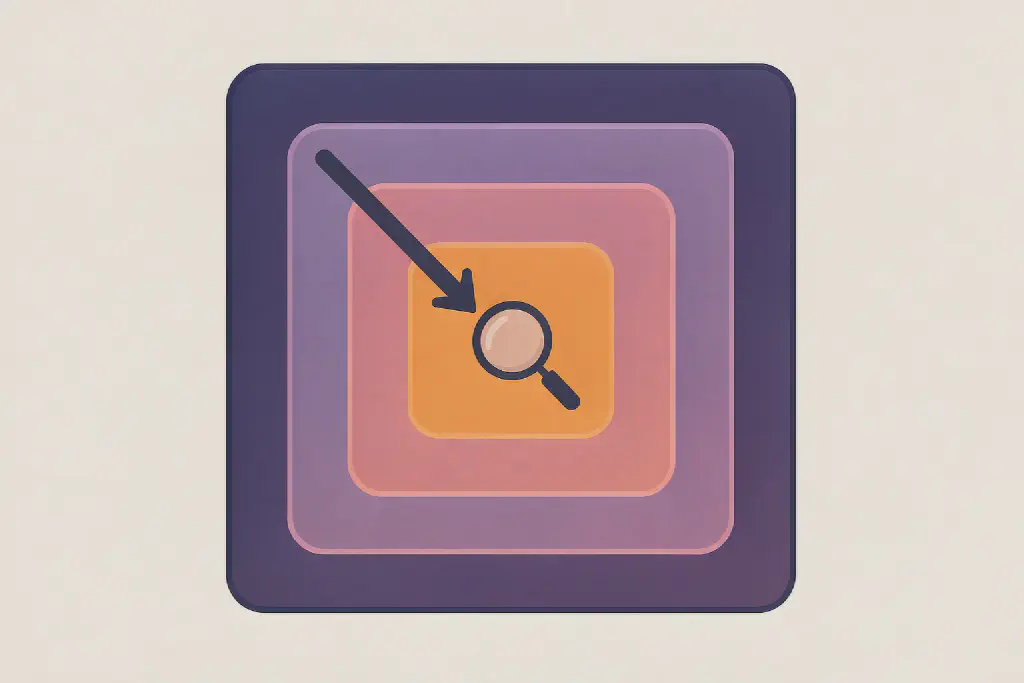
同一套评审从合并请求一路前移到未提交改动、实现计划与工单,反馈越早、返工越少
现实压力来自套件本身:造测试的工具太好用,容易写过头,攒出要跑几小时的巨型套件和夜间构建。设想一位开发者从一天开一个合并请求变成一天开十二个,每次都跑同一套巨型套件,反馈速度立刻变成新瓶颈。自动化最终会变成什么形态没有干净答案,但把它当唯一手段一定窄了。
五、把能力迁到 eval 上
角色边界正在重叠,与其守住岗位名称,不如看哪些工作需要测试能力。eval engineer 是典型:设计评估来衡量一个 AI 系统表现如何、在哪儿失败、某次改动让它变好还是变坏——出题目、定义什么算好答案、批改它的作业。
举个能直接照做的例子。助手声称「会议已预订」,评估要检查会议是否真的存在、时间是否正确、受邀人是否对;还要检查评估器本身:在助手根本没做到时,它能不能发现。后者最容易被跳过,却决定了整套评估有没有意义。换模型同理,升级到最新模型不能自动证明系统变好了,得有人去量。
有个实测值得记住:同一个 agent 分别在带 skill file 与不带的情况下完成任务,同时量输出质量、token 消耗与响应时间。直觉上加了技能该更好,结果主要是多烧了大量 token,回答并没有明显改善。看起来理所当然的改进,不量就不知道。
六、通才视角:先判断该不该写
测试本来就需要很宽的知识面:业务、客户与需求,用户体验、行为、性能、可访问性,还有代码本身。同一个产品从多个视角看,这种习惯值得继续加码。
有个反例很说明问题:一支很强的团队做出能按描述起一个跑得起来、测试全绿的应用的产品,但没有人愿意用。技术上成立,不等于用户想要、需要或愿意付费。能做出来 和 该做出来 之间,仍然需要有人理解用户、选对问题、处理取舍。宽视野让我们有机会在检查代码对不对之前就参与进去。
明天就能开始的四件事
- 选一个真实工单,把生成与验证拆给不同模型,记录
review agent到底抓到了什么 - 把评审从合并请求前移一级到未提交改动,量一次返工量的变化
- 给自己系统里一个会回报成功的场景写评估用例,再故意造一次失败,验证评估器能抓到
- 统计一次巨型
E2E套件的运行时长与合并请求频率,判断它是否已成瓶颈
头衔会变,组织会变;定义什么算成功、发现假设之外的失败、把模糊问题变成可验证的实验,这些能力可以跟着人走。把力气花在这里,比推演 AI 会拿走什么更实在。