某个电商健康平台要在次日零点开一场冬季闪购。营销排期就绪,业务方预计会有一次明显的流量抬升。测试同学打开压测工具,配了 3000 个虚拟用户跑了一轮:响应时间达标、错误率很低、应用运行平稳,于是给出结论——性能通过,可以上。
零点到来的那一刻,数千用户同时涌入,商品页开始失去响应,结算请求接连失败,最后应用整体崩溃。
压测确实跑过了,报告也确实是绿的。出问题的地方在于:那轮压测只证明了「在 3000 虚拟用户这个设定下应用还能跑」,没有回答「整个系统能不能承接业务方预期的那场流量」。这两件事之间隔着的,不是更多的虚拟用户,而是开测之前就该算完的几笔账。工程上把这类粗算叫信封背面计算:不追求精确,只求在动手之前把量级、余量和可能的瓶颈摆到桌面上。
一、第一笔账:峰值不是平均值
业务方说「一小时内预计 5000 位顾客」。摊到 3600 秒,约等于每秒 1 人,听起来毫无压力。但促销流量的分布从来不是均匀的:如果 5000 人集中在开场前五分钟进入,这五分钟里的平均到达率就是每秒约 10 人;而「平均」仍然掩盖了更真实的形态——几百个请求挤在两三秒内到达。
把平均值直接当成压测模型,是最常见也最隐蔽的一个错误。它让脚本看起来合理,却让系统在最需要扛住的那几十秒里完全没有受过检验。
开测前至少要把这几个问题问清楚并写进场景设计:
- 预期的总流量是多少,依据是什么,是注册量、历史同场次数据还是营销预估?
- 预计的并发用户数是多少,而不是「一小时内会有多少人来」?
- 开场前几分钟的可能峰值是多少,秒级突发按什么量级估?
- 常规负载、峰值负载、尖峰负载、超极限压力这四类场景是否都跑过?
- 脚本里的用户行为像不像真实顾客:浏览、加购、改数量、结算,还是一上来就打结算接口?
- 是否模拟了「同时」,而不只是「高频」?
工具只负责把流量造出来,场景是否代表真实业务,是人的责任。这一步的输出不该是一个线程数,而是一组带着假设的场景描述。
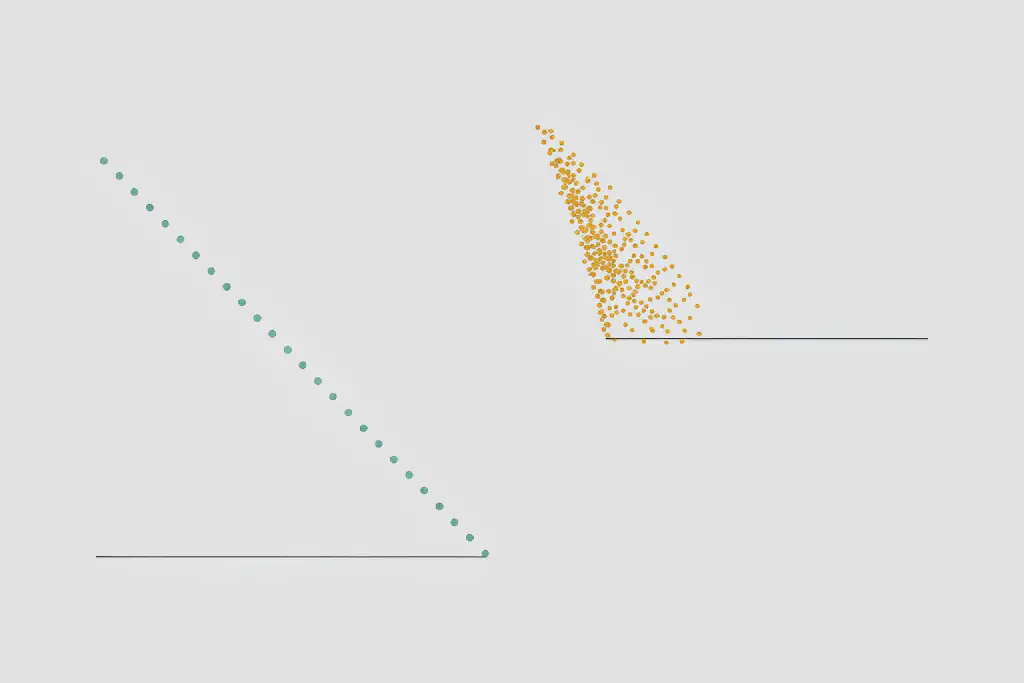
把「一小时 5000 人」摊成平均值,与按开场五分钟尖峰建模,得到的是两套完全不同的压测脚本
二、第二笔账:内存余量够不够
一个能站 3000 人的门店,一下子进来 5000 人,门口先堵,然后整个店运转不动。应用服务器是同一回事:每个活跃请求和会话都在占用内存与 CPU,而这些资源有明确上限。
粗算的方法很朴素,把三个数摆在一起就能看出风险:机器可用内存、单个活跃请求的平均内存开销、峰值并发请求数。举个量级示例:可用内存 8 GB,单请求约 9 MB,3000 并发请求仅请求本身就在 27 GB 量级,已经远超这台机器的容量。即便实际开销因复用、缓存、连接池而低于这个乘积,结论也不会变——在预期流量到达峰值之前,服务器容量就可能先成为瓶颈,而且它往往不是被「算」出来的,是被 OOM 日志宣告的。
资源被打满之后,系统的表现不是简单地变慢,而是一串连锁反应:内存占用持续抬升、响应时间先劣化、请求开始超时或失败、最后进程因内存溢出被杀掉。更麻烦的是降载之后能不能自己缓过来——如果内存不回落,说明还有泄漏,第二波流量会更早崩。
因此压测时的观测清单要覆盖行为,而不只是「服务还活着」:
- 可用 RAM 与 CPU 是多少,压测前的基线值是多少?
- 负载下应用实际吃多少内存,随并发增长的曲线是否线性?
- 内存是否持续上涨且降载后不回落,是否存在泄漏?
- 从哪个负载档位开始出现性能劣化,拐点在哪?
- 流量回落之后应用能否恢复到基线,恢复需要多久?
这些数字的价值不在于写进报告,而在于把「基础设施风险」提前交给开发和运维,而不是等生产环境来公布答案。
三、第三笔账:队列能不能把洪峰削平
假设 5000 位顾客几乎同时加购并下单,而购物车与支付链路一次只能处理 100 个请求。若 5000 个请求被原样灌进去,过载、结算延迟、支付失败甚至重复交易都会一起出现。
队列的作用是把适合异步处理的任务先收下,再按受控速率交给 worker 慢慢消费。订单通知、库存更新这类后台操作适合走这条路;但购物车更新、支付授权一般需要即时处理或即时确认,不能一概塞进队列。哪些能异步、哪些必须同步,本身就是设计决策,压测之前就该确认,而不是等出了问题再改。
队列自己也有上限。入队速度长期快于消费速度,消息就会堆积;到达最大容量后是丢弃、阻塞还是拒绝,取决于配置,也直接决定用户看到什么。真正的风险集中在失败与重试的边界上:worker 处理到一半崩溃,消息会不会丢?失败消息重试时会不会产生第二笔订单?用户因为超时又点了一次支付,会不会重复扣款?队列过载之后系统能不能自己恢复,订单状态是否仍然一致?
这些问题里,只有一部分能从接口状态码看出来。要验证的是端到端结果:订单没丢、没重、状态一致、支付没有二次扣款。
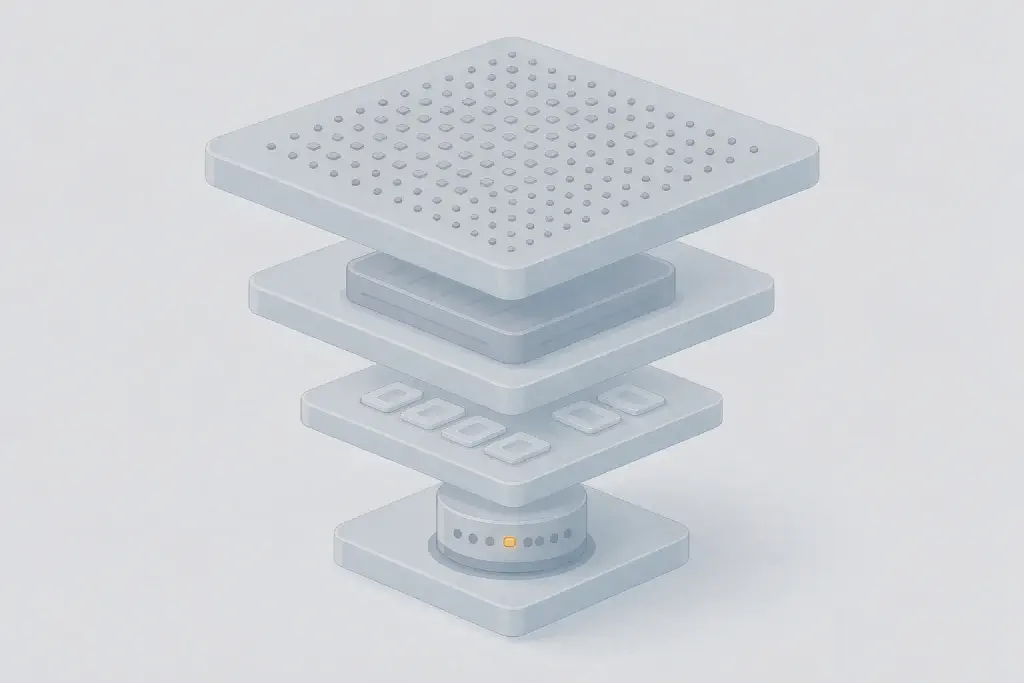
从流量尖峰到内存、队列、数据库连接池,四层容量约束逐层收窄,任何一层都会成为实际瓶颈
四、第四笔账:数据库连接池是那个「唯一收银台」
5000 人都挑好了商品准备付款,店里只有一个收银台。应用服务器可以横向扩到几千并发,数据库能同时处理的连接和事务却常常是固定的。比如应用收到 5000 个请求,而连接池只允许 500 个活跃连接,剩下几千个请求只能排队等连接,接着开始超时,最后报出连接数耗尽或连接超时。
这类瓶颈有个特点:加应用服务器不会缓解它,反而会把更多请求压到同一个池子上。所以只盯 API 响应码的压测,很可能全程绿灯,直到生产环境把连接池打满。
需要提前确认的包括:
- 数据库最大连接数是多少,压测期间峰值用到了多少?
- 连接在使用后是否被正确释放,连接池的等待队列与超时怎么配?
- 有没有慢查询、缺失索引,长事务是否长期占着连接?
- 到达连接上限时应用的行为是什么:快速失败、排队,还是拖垮整个上游?
- 哪些重复读可以用缓存挡掉,哪些后台操作可以改为队列处理?
数据库这一层的结论通常不是「通过 / 不通过」,而是一个可接受并发上限,以及超过上限时的降级行为是否可控。
五、把四笔账变成开测前的一页清单
四笔账其实对应四个提问对象:业务方给流量预期,开发给架构与依赖边界,运维给资源与配置现状,测试把三者拼成场景和判据。顺序也很关键——先对齐假设,再定阈值,再跑压测,最后看恢复。
一个可以直接拿去用的开测前清单:
- 流量与尖峰:预期峰值并发是多少,四类负载场景是否齐备,脚本是否复刻真实用户路径?
- 服务器余量:内存与 CPU 基线、单请求开销、劣化拐点、降载后是否恢复?
- 队列与重试:哪些任务异步、队列上限与满队列行为、失败重试是否会产生重复订单或重复扣款?
- 数据库:连接池上限、峰值占用、慢查询与索引、连接耗尽时的降级表现?
- 共同判据:各层的性能阈值是多少,超过阈值算失败还是算观察项,压测后是否验证过恢复能力?
把这张清单在压测前与开发和运维过一遍,很多瓶颈会在写第一行脚本之前就浮出来。它们本来就不该由生产环境首次发现。
六、从「跑完测试」到「对就绪负责」
会用压测工具、能配虚拟用户、能出一份漂亮的报告,这些都只是执行层。真正决定一场大促会不会崩的,是有人愿意去理解业务预期、追问系统背后的容量结构、挑战「均值即峰值」这类默认假设,并在信息不足时把风险明确说出来。
这不需要先成为系统架构师,需要的是在系统上线之前把该问的问题问完。负载测试交出的不该是一句「测试通过」,而是「我们对系统在预期流量下的行为有足够信心,并且知道它在哪一点会先撑不住」。
测试的职责不在报告变绿那一刻结束,在信心建立起来那一刻才结束。