一个 MCP server 能启动、不报错,跟它真的能用是两回事。每个工具是否接受你以为的参数,返回值是不是模型期望的结构,失败时究竟算工具报错还是协议报错——这几件事,靠把 server 挂进 AI 客户端再问模型,往往问不出来。那条链路慢,而且模型横在你和 bug 中间。
更直接的做法是把模型拿掉:用一个本地 Web UI 直连 server,把它提供的工具、资源、提示列出来,逐个手工调用,同时把每一帧 JSON-RPC 报文看完整。下面是一整轮调试会话的七个步骤,从启动到接上自己的服务。
先把模型从链路里摘出去
多数人的排查方式是接客户端、发指令、盯结果。问题在于,当结果不对,你分不清是工具参数写错了、server 没应答、还是模型自己理解偏了。
直连的价值就在这里:调用是你发的,参数是你填的,回包是原样的。需要回答的四个问题变得可判定——工具收没收到预期参数、返回结构对不对、失败以哪种形式表达、耗时是否异常。模型只在最后一步才该出现。
一条命令起一个本地调试台
不需要安装,也不需要构建:
npx mcp-master-tester
浏览器打开 http://127.0.0.1:6280。端口被占用就换一个:
PORT=7000 npx mcp-master-tester
后端是 Express,前端是原生 JavaScript,几秒就能起来,还会跟随系统的深浅色主题。前置条件只有 Node.js 20 或更高版本。
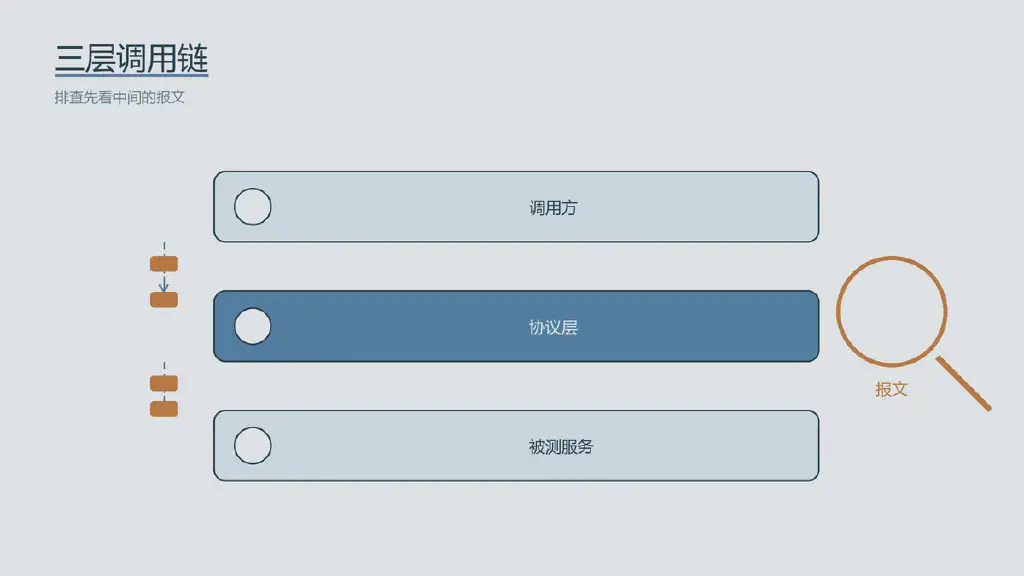 图 1|调用方、协议层、被测服务三层关系,排查时先看中间的报文
先连参考实现,看健康的服务长什么样
连接表单默认填好了一个 stdio 连接到官方参考 server:
npx -y @modelcontextprotocol/server-everything
点连接后,后端把 server 作为子进程拉起,跑完 initialize 握手,侧栏就列出它提供的全部能力:tools、resources、resource templates、prompts。
先连参考实现而不是自己的代码,理由是它把协议里的每种特性都跑了一遍。见过健康的服务长什么样,自己服务里的异常才显眼。这一步也很适合用来确认你的客户端环境本身没问题。
表单由 schema 生成,必填项在发送前就拦住
选中一个工具,界面会读它的 inputSchema 自动生成表单:字符串、数字、整数变成输入框,布尔值变成开关,enum(含 oneOf / const 带标题)变成下拉,数组变成多选,对象给一个 JSON 编辑器。
必填字段在请求发出前就校验,缺参数会在表单层被挡下,而不是变成一句含糊的 server 错误。表单碍事时可以切到 Edit as JSON 直接写参数。工具慢就设超时,长任务会从 notifications/progress 流式回传进度;带破坏性标注的工具会先要一次确认。
结果查看器把回包拆开显示:文本(JSON 会格式化)、图片和音频、资源链接与内嵌资源、structuredContent,以及这次调用花了多久。每个工具还保留自己的调用历史,换参数重跑可以直接对照。
两种失败必须分开看
这是整轮调试里最值得记住的一点。工具失败有两种表达方式:
- 返回
isError: true的结果,表示工具跑完了并报告失败 - 调用本身抛
JSON-RPCerror,表示协议层断了
调试台把两者分开显示,这不是洁癖。如果本该返回 isError 的场景抛成了协议错误,另一端的模型能拿到的信息会少得多,很可能只看到一次失败而不知道原因。这被列为 MCP server 里最常见的 bug 之一,值得在自测清单里单列一项。
资源、提示与中途追问
静态资源点一下就读。带变量的资源模板(形如 file:///{path})会给每个变量一个输入框,填完再读;文本和 blob 内容都能显示,可以确认二进制资源没有在传输中被破坏。
提示也一样,选中后填参数,界面给出模板返回的完整消息——这是检查参数替换是否符合预期最快的方式。
有些 server 会在调用中途通过 elicitation/create 反过来问用户要信息。调试台会按 requestedSchema 生成表单,把你的回答送回去,URL 模式也支持。如果服务用了 elicitation,这是不接真实客户端就能测完整往返的最简办法。
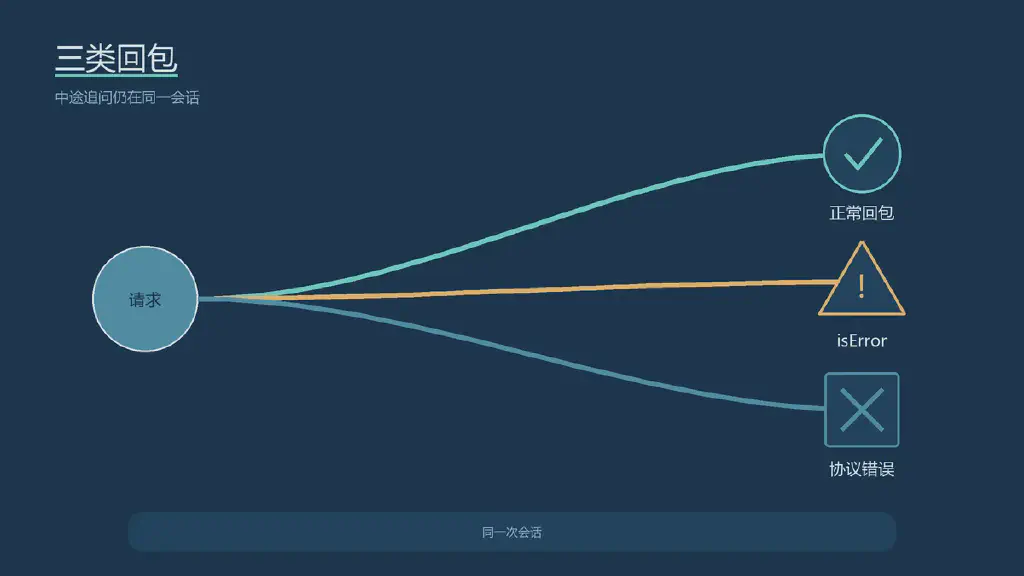 图 2|区分正常回包、
isError 与协议错误三条分支,中途追问仍在同一次会话内
结果不对时,先读报文再读代码
协议日志按时间从旧到新记录:双向每一帧 JSON-RPC、请求到响应的耗时、server 的 stderr、notifications/message 日志条目,还能用 logging/setLevel 调整服务端日志级别。
顺序很重要。结果看着不对时,先读原始帧再翻自己的代码:客户端到底发了什么、server 有没有应答、花了多久。很多「工具坏了」最后都是这里能一眼看出的错配——参数名写错、响应里少了字段、或者进程崩溃把堆栈打到了 stderr。
手工能跑通,模型仍可能用错
工具手工调用一切正常,模型却可能用错,因为模型只知道定义里写了什么。Lint 报告按规范和良好实践逐条检查每个工具定义:
inputSchema与outputSchema必须是 object 类型- 每个 required 字段都得真实定义过
- properties 应带 type 和 description
- 工具名格式规范且不重复
- 工具应带 annotations(例如是否只读、是否破坏性)
该把 lint 结果当 bug 处理:缺 description,模型就只能猜参数用途;缺 annotation,客户端没法在破坏性操作前提醒用户。改完定义、重连、再跑一次 lint,直到干净。
接到自己的服务
按部署形态选连接方式:
- 本地 npm 包(
stdio):命令npx,参数-y @modelcontextprotocol/server-filesystem /path/to/dir - 本地脚本(
stdio):命令python,参数my_server.py,按需填工作目录 - 需要密钥(
stdio):点+ var,例如GITHUB_PERSONAL_ACCESS_TOKEN - 远端现行规范(
Streamable HTTP):填https://host/mcp,必要时加 Bearer token - 远端旧规范(
SSE):填https://host/sse
远端流量经 Node 后端转发,不会撞上浏览器 CORS。凭据缺失时也有兜底:远端返回 401 会提示输入 token 后重试;stdio 进程崩溃且 stderr 提到缺密钥时,会建议把它加成环境变量重连;名字里含 KEY、TOKEN、SECRET、PASSWORD 的变量自动打码。
连通之后可以存成 profile,但 profile 只存名字、不存密钥,所以每次连接仍要重新输入。
本地工具的边界
这个调试台能执行你在 stdio 表单里填的任何命令,因此设计上刻意只留在本地:后端只监听 127.0.0.1,Host 头不是本机或 localhost 的请求一律拒绝(挡掉恶意站点的 DNS rebinding),密钥只存在于浏览器标签页和后端进程的内存里,点 Run 之前什么都不会执行。
还没覆盖的两处要心里有数:远端 server 的 OAuth 登录流程尚不支持,得用 Bearer token 或自定义头;sampling/createMessage 与 roots 不会向 server 声明。
每次改动后的固定动作
连上、跑 lint、把改过的工具逐个调一遍、扫一遍协议日志里的报错和慢响应——这四步可以固化成每次改 server 的收尾动作。
它解决的其实是一个朴素的问题:调试 MCP server 不该非得把模型拉进来。调用直连、参数由 schema 生成、报文逐帧可见、定义按规范校验,模型该依赖的那份描述也就顺带被验过了。
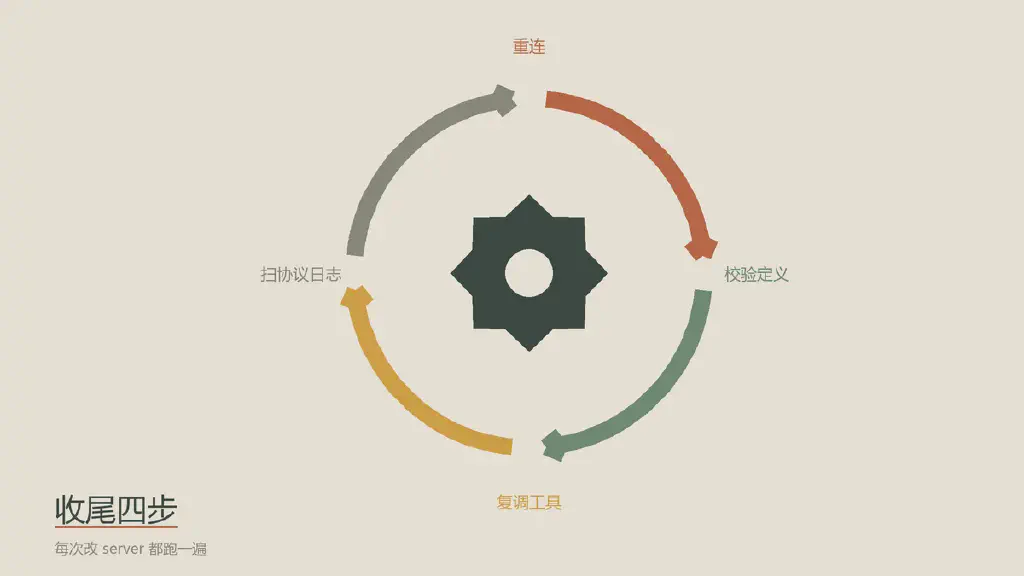 图 3|重连、校验定义、复调改动工具、扫协议日志,构成一个可重复的收尾动作