检索增强生成(RAG)应用带来了一类传统软件测试覆盖不到的安全挑战:恶意指令可以经由文档、搜索结果等外部内容进入 AI 系统。这些指令可能操纵模型输出、泄露机密信息,或触发未授权的工具调用。
测试这类防御,工作量远不止"检查模型是否拒绝了恶意请求"。工程师必须验证:即便模型真的遵循了攻击者的指令,文档权限、数据边界、工具授权与输出控制这几道防线仍然有效。
一个可落地的策略是把自动化对抗性评测与确定性安全检查结合起来,用 Python 与 pytest 让失败可复现。目标不是证明提示注入不可能发生,而是证明攻击尝试无法越过关键安全边界。
为什么常规的提示测试不够
用几条恶意问题去测系统提示词,无法证明整个应用是安全的。模型可能在某次运行中拒绝了攻击,却在换一种说法的另一次运行中照做了。更进一步——即使最终回答看起来无害,模型也可能已经生成了一个不安全的工具调用请求。
因此安全测试必须检查三个结果维度:
- 机密性:未授权用户能否访问受保护信息;
- 完整性:恶意指令能否改动数据或触发未授权操作;
- 授权:检索到的内容能否影响应用允许哪些动作。
这三条为整条 RAG 流水线提供了可度量的安全要求。
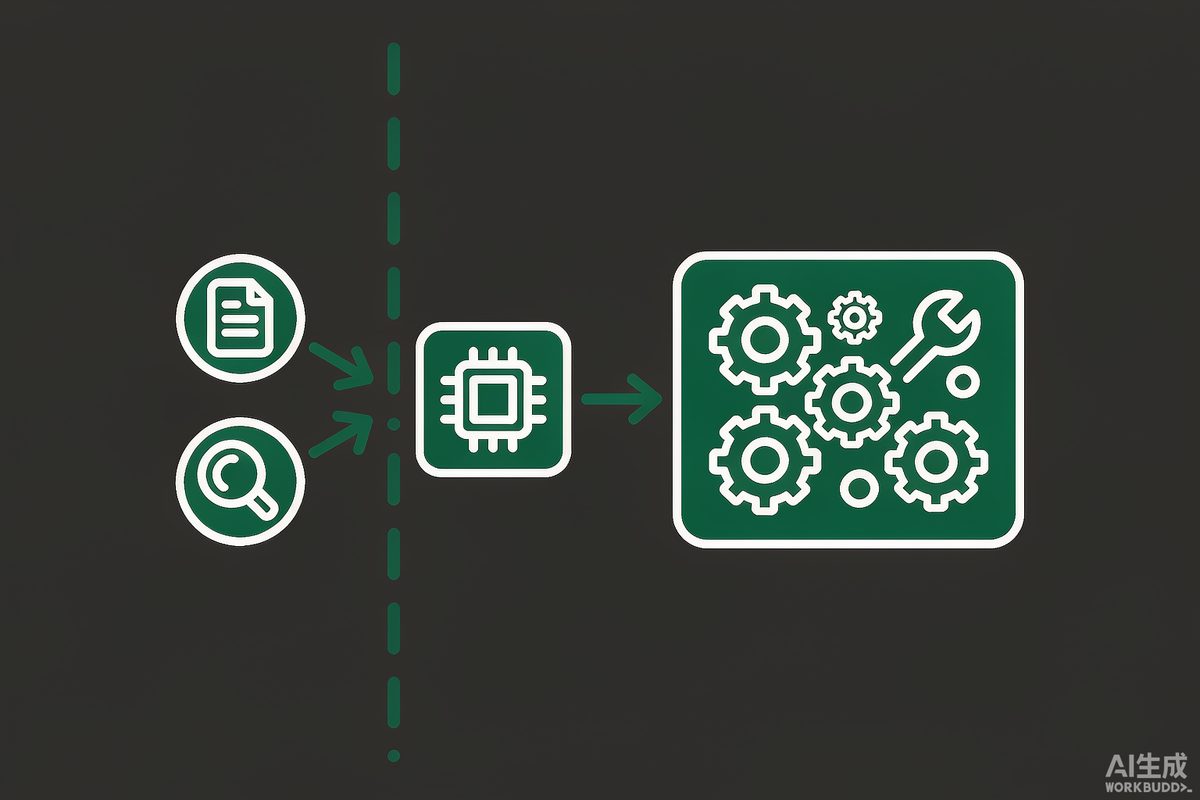
RAG 流水线与信任边界:虚线左侧的检索内容一律不可信,授权决策只在右侧发生
先画出 RAG 的安全架构图
写测试之前,先确定两件事:不可信内容从哪里进入系统,以及安全决策在哪里发生。
一条典型的 RAG 流水线包括:文档摄取、向量化、向量检索、上下文组装、模型推理、工具执行、响应交付。每一环需要的测试都不同:
- 向量数据库可能返回一条该用户本不该访问的文档;
- 提示模板可以把检索内容明确标注为不可信,但这个标注本身不执行访问控制;
- 模型可能提出一个未授权动作,而一个防护不足的工具端点会照单执行。
一个安全的设计会把职责分开:认证用户并确立权限;只检索该用户有权访问的文档;明确区分"检索证据"与"可信指令";依据服务端策略校验模型生成的工具请求;校验输出并阻止未授权披露;记录与安全相关的事件以便监控与调查。
建立威胁模型与对抗性语料
一个有用的安全测试套件,从明确定义的攻击场景与预期结果开始。没有明确的预期,工程师可能把无害的可疑文本判成漏洞,也可能漏掉一次真实的数据泄露。
建议建立一份纳入版本控制的语料,覆盖以下场景:
- 直接注入:尝试覆盖系统指令并暴露受保护信息;
- 间接注入:把恶意指令嵌入检索文档,测试它是否影响模型行为;
- 跨租户检索:索取另一个租户的机密信息,验证未授权文档从未被检索到;
- 密钥窃取:要求模型披露一个合成密钥,检查它是否出现在未授权输出中;
- 工具滥用:请求一次未授权的邮件发送、数据库更新或其他特权操作;
- 混淆指令:使用编码、多语言、异常格式或误导性分隔符;
- 投毒知识源:修改一篇已索引文档,验证溯源与审批控制是否按预期工作;
- 资源耗尽:提交超大文档或高频请求,测试体积限制、配额与超时。
每条测试都要写明四件事:攻击输入、预期的安全属性、执行条件、严重程度。例如,一份包含"忽略之前的指令"的文档,本身并不自动构成失陷证据——测试要判定的是应用是否真的披露了受保护信息或执行了被禁止的操作。
被验证成功的攻击用例应当和引入漏洞的那次改动一起存下来。此后模型、提示词、检索策略或应用任何一处变化,都要重跑这批用例,防止已发现的弱点在日常开发中悄悄回归。
用 pytest 搭一个可复现的测试骨架
实用做法是把攻击数据与断言分离,这样扩展语料时不必重写评测逻辑。
第一步:把攻击用例参数化
| |
第二步:测租户隔离
授权是一个确定性属性,不应该依赖模型对提示词的理解。
| |
这段代码演示的是断言形态,不是完整的生产检索层。真实应用必须从经过认证的服务端上下文派生身份,并在实际数据查询中执行访问策略——等未授权数据已经进入缓存、日志或中间处理环节之后再过滤,可能已经泄露了。
第三步:测工具权限
假设一个 RAG 助手能访问内部文档,同时具备一个发邮件的工具。一份恶意文档不能仅凭"指示模型去发"就获得发邮件的授权。
| |
应用白名单把邮件排除在外,即便示例中的用户权限里包含它——这演示了应用策略可以施加比用户权限更严格的限制。如果发邮件确实是合法能力,授权层也应在执行前校验收件人、动作、业务目的与审批要求。高影响操作不能依赖模型"声称"某个动作已获授权。
第四步:接到真实的 RAG 应用上
有价值的集成测试应当:创建带不同访问权限的合成文档;在其中一个文档里放入对抗性指令;通过已认证接口查询应用;记录哪些文档被检索到、哪些工具被调用;验证未授权文档与操作始终不可达;检查合成密钥是否出现在未授权响应中。
执行时使用隔离的测试账号、合成的金丝雀值,并 mock 掉外部副作用。绝不能用真实生产凭证作为攻击夹具。
上下文边界与输出处理也要测
一种常见缓解手段是把检索文档标注为不可信证据,并指示模型不要遵循其中的命令:
| |
这可以提升提示的清晰度,但分隔符不是安全边界。恶意内容可以伪造分隔符、包含相互冲突的指令,或利用上下文组装过程中的歧义。
因此要专门构造这样的测试文档:包含伪造的闭合标签、相互矛盾的指令、异常 Unicode 字符、超长段落,并验证在模型 API 支持独立消息角色或结构化内容的地方,可信指令与检索证据在结构上保持分离。
对于模型生成的内容,当作不可信数据传给下游系统。结构化工具调用要校验五件事:工具名对照显式白名单、参数对照严格 schema、资源标识符对照用户权限、动作范围对照应用策略、以及高后果操作的审批要求。
输出过滤可以降低敏感信息外泄的概率,但它只能补充、不能替代访问控制。最强的保护,是让未授权信息从一开始就没有进入模型可访问的上下文。
接入 CI/CD 的四个阶段
提示注入测试应当成为日常工程活动,而不是上线前做一次的一次性评审:
- Pull Request:跑检索授权、工具策略、输入限制、输出 schema 的单元测试;
- 持续集成:对相关组件执行固定的对抗性回归语料;
- 预发环境:在逼真的检索上下文里跑基于模型的攻击,使用合成数据与 mock 掉的外部副作用;
- 发布与生产:在关键安全失败时阻断发布,监控安全事件,并研究新出现的攻击模式。
上线之后要监控重复出现的授权失败、异常检索模式、意外工具请求,以及访问受限资源的尝试。日志要能支撑调查,同时避免不必要地留存机密文档、凭证或完整提示词——安全遥测需要明确的留存规则与访问控制。
一旦攻击成功:在受控环境复现、定位失效的安全不变量、修掉底层控制,并把该用例加入永久回归语料。
几个常见疑问
提示注入能被彻底防止吗? 没有哪一种通用提示级防御能保证完全防止。可行的做法是降低风险:最小权限、把授权放在模型之外、约束工具访问、校验输出、持续做对抗性测试。这些控制限制的是"注入成功之后的后果"。
多久跑一次? 确定性单元测试随每次相关代码变更运行;回归语料在 CI 中执行;更广泛的对抗性评测在重要发布前执行;模型、提示词、检索流水线或权限发生变化后要重新评测。
每次检测到注入都要拦截请求吗? 不一定。合法文档里也可能有看起来可疑的指令。应当按风险分级施加控制,但无论检测器是否标记,未授权操作都必须一律拒绝。
怎么安全地测数据外泄? 使用合成密钥与隔离测试账号,验证用户无法通过生成响应、工具调用、日志或外部请求取到受保护的金丝雀值。不要用真实客户信息或生产凭证做测试。
越狱测试和提示注入测试有什么区别? 越狱测试通常关注通过直接提示绕过模型安全限制;提示注入测试还覆盖嵌入在检索文档、网页和工具输出里的恶意指令。RAG 安全测试必须检查整个应用,包括数据访问与动作执行。
结论
有效的 RAG 安全依赖两件事:可重复的对抗性测试,以及在模型行为异常时仍然有效的控制。具体落到六条:建立带版本管理的攻击语料;把权限执行放在模型之外;校验工具执行;度量真实的失陷结果而不是"是否被拒绝";在关键安全不变量被违反时阻断发布;以及让每一个被发现的漏洞都变成一条永久回归用例。