重试不是修复。加长超时不是修复。隔离清单不是修复。那个团队共用的、专门用来发"已知不稳定,忽略即可"的 Slack 频道,更不是修复。
这些话大多数测试团队都认同,但真正的问题在于:移动端 E2E 测试之所以不稳定,原因和 Web 测试根本不是同一类;而每一个从 Web 玩法里借来的解法,都会让问题在结构上持续恶化。
一个反复出现的过程是这样的:一个团队接手端到端测试套件,测试开始失败时加自动重试,重试不够就把超时调长,最后彻底不再信任这套用例。CI 变红时没人去看,也没人知道那是真的缺陷还是"又是一个普通的周二"。
这不是纪律问题。问题在于移动端 E2E 有四种 Web 端根本不存在的失效模式,而 Web 优先的修复思路,把错误的心智模型一起搬了过来。
移动端的不稳定是一个不同的问题
Web 自动化跑在浏览器里。浏览器是一个沙箱化的、大体确定性的环境:DOM 可查询、动画可关闭、网络请求可拦截、渲染引擎跨运行表现可预测。Web 测试不稳定时,原因也早已被研究清楚——异步等待、测试顺序依赖、共享状态污染,任何一本测试教材都会讲到。
移动端自动化跑在一整个操作系统之上,这一差别改变了所有从 Web 测试借来的假设。
一个移动应用测试必须应付测试脚本从未触发过的系统级中断;必须应付一个"点击时机差 10 毫秒结果就不同"的手势模型;必须活过那些在第 47 次运行和第 1 次运行行为不同的 CI 模拟器;还必须在一个设备生态中产出一致结果——仅 Android 就横跨数千家厂商和数十个仍在活跃的操作系统版本。
用 Web 的解法修移动端的不稳定,就像拿汽车刹车维修手册去诊断飞机液压系统故障:词汇是重叠的,物理规律不是。
针对 Web 成因的那些修复(统一异步等待模式、隔离测试状态、强制测试顺序)对 Web 的问题是对的。放到移动端,它们大概只能解决一半问题,另一半的成因不同,需要不同的解法。
从数据看,这个问题并没有随着工具成熟而好转。一份覆盖三年、超过一千万次构建的移动开发行业报告显示,报告测试不稳定的移动团队比例从 2022 年的 10% 上升到 2025 年的 26%。流水线越复杂,不稳定越严重。
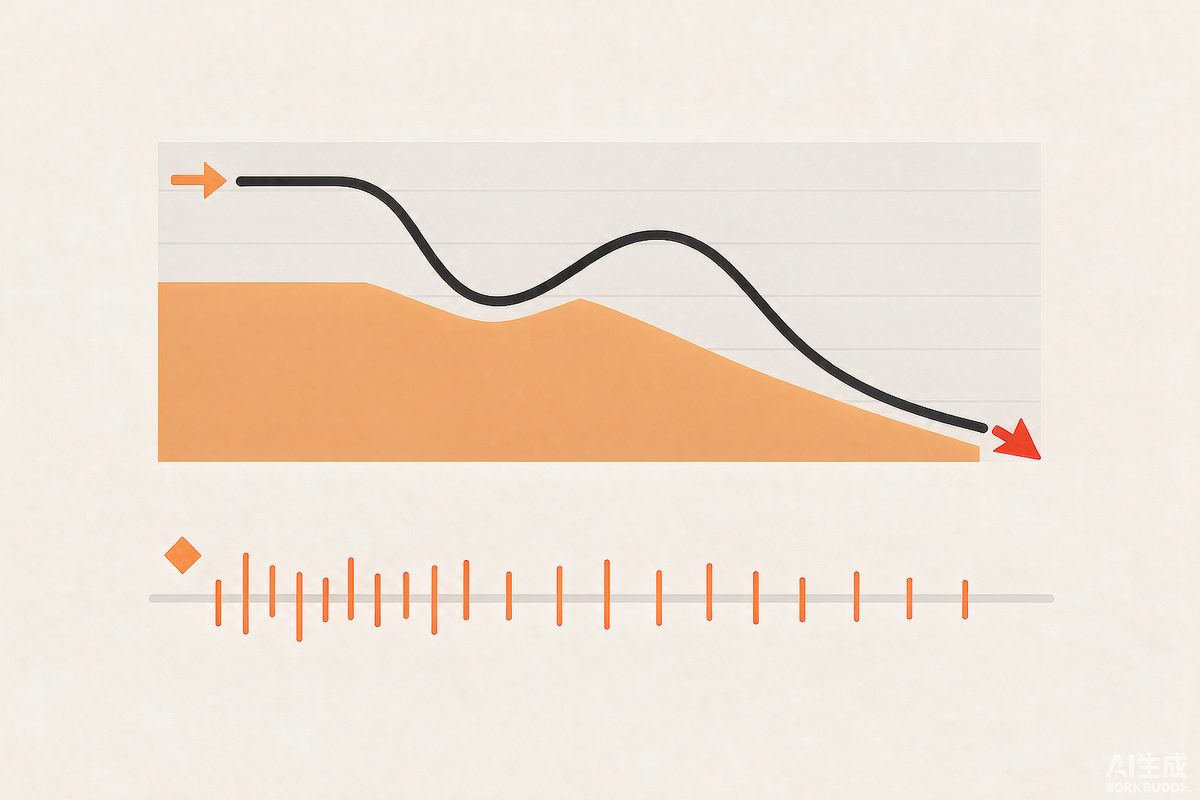
上半:模拟器响应能力随运行推进持续劣化;下半:手势时序的判定边界并不等距
四种 Web 测试从未见过的失效模式
一、模拟器行为漂移
CI 流水线跑在模拟器上,不是真机。模拟器是硬件的软件模拟,和任何运行在资源受限 CI 环境中的软件一样,它的行为会在单次测试运行的过程中持续劣化。
套件刚开始时模拟器响应良好:GPU 加速是热的、内存干净、虚拟 CPU 有余量。四十个用例之后,同一个模拟器可能正处在内存压力下、虚拟 CPU 正在降频,或者因为事件队列积压而开始丢弃手势事件。测试代码一模一样,环境已经漂了。
Web CI 环境没有同等规模的问题,因为浏览器实例轻量且无状态。而模拟器跑的是一整个移动操作系统:摄像头驱动、蓝牙协议栈、网络模拟、GPS 模拟——哪怕你的测试只碰了一个登录页面,这些也全都在跑。
典型症状是:稳定通过的位置 1–15 的用例,到了位置 30–50 开始间歇性失败。开发者的反应是加重试;重试偶尔有效,因为第二次尝试恰好赶上模拟器状态稍好的时刻;而根因——模拟器在运行中途改变了行为——从未被处理。
二、手势时序敏感
移动端交互的本质是手势。一次轻点不是一次点击,一次滑动不是一次滚动,这个差别比听起来重要得多。
浏览器点击会触发一组离散事件(mousedown、mouseup、click),DOM 以可预测的方式处理。移动端手势则是一串带有时间属性的触摸事件流,由操作系统结合上下文解释:按住 100 毫秒是轻点,按住 500 毫秒会触发长按上下文菜单;一次起手位置偏左 5 像素的滑动,在特定设备或系统版本上可能被识别成滚动而不是滑动。
自动化框架确实暴露了手势 API,但底层时序行为因 iOS 与 Android 而异、因系统版本而异、也因模拟器与真机而异。一条在本地模拟器上稳定的手势命令,可能在一台虚拟化特征不同的 CI 宿主机上失败。长列表往往最先暴露这种差异,因为一次快速滑动跨越的行数每次都不同——这也是为什么无限滚动的测试通常会一次只滑一步、然后等目标单元格出现。
Web 没有这个问题,点击事件在浏览器层被抽象掉了。移动端开发者没有等价的抽象层,只能直接对接一个因实现而异的操作系统手势模型。
三、系统权限弹窗
iOS 和 Android 会在应用流程中弹出系统级权限对话框:相机、麦克风、位置、通知、通讯录、蓝牙。这些弹窗不是你的测试触发的,是操作系统依据内部状态决定何时展示。
弹窗一旦在测试中途出现,就会盖住界面。测试脚本尝试点击一个已经被遮挡的元素,点击失败,元素找不到,测试报告一条与被测代码毫无关系的失败。
弹窗出现的时机并不完全确定:干净的模拟器状态可能在第 1 次运行不弹通知权限,而在第 3 次运行弹出,因为此时应用已安装得足够久,系统决定该提示了。团队的应对是在测试 setup 里加"关弹窗"逻辑;而系统行为随 iOS 与 Android 版本变化,在某版本上有效的 setup 脚本,在另一个版本上会静默失效。
这一类不稳定尤其昂贵,因为失败报告指向的是错误的元素——脚本当时想点的那一个,而不是真正挡住它的那个弹窗。
四、网络状态与设备碎片化
移动应用运行在 Web 应用基本不用面对的网络条件里:WiFi 与蜂窝网络切换、请求过程中应用被切到后台、运营商特有的 DNS 行为、以及随信号质量变化的延迟。
一个在纯 WiFi 模拟器上通过的测试,可能在真机上因为中途切到蜂窝网络而失败;一个能处理 200 毫秒 API 响应的测试,可能在网络模拟设置不同的 CI 环境里失败。这些不是异步等待问题,而是环境保真度问题:测试环境和真实运行条件不一致。
设备碎片化会进一步放大它。Android 生态从 1GB 内存、跑 Android 9 的入门机,一直延伸到当前旗舰硬件。一个针对"高配虚拟机 + Android 14 模拟器"设计的测试,在真实入门硬件上会遇到渲染时序差异、内存管理差异和垃圾回收行为差异。仅屏幕密度差异一项,就足以让在某台设备上生效的点击坐标在另一台上落空。
基于选择器的测试套件假设视图层级跨设备稳定——而它经常并不稳定。
为什么脚本级的修复会让情况更糟
面对移动端不稳定,标准动作是一条可预测的升级路径:先重试,因为它是最省力的杠杆;然后加超时,因为多给点时间通常能让模拟器漂移和手势时序问题最终蒙混过去;最后隔离,因为有些用例稳定地不稳定,团队干脆不再指望它们通过。
三者各有代价,而且都不出现在 CI 仪表盘上。
重试会掩盖真实失败。 第三次重试才通过的用例,是一条恰好走运的不稳定用例;它同时也可能是一次被重试逻辑盖住的真实回归。有一项被广泛引用的研究发现,不稳定导致了其测试套件中 84% 的"通过转失败"状态迁移——这意味着依赖重试的团队,正在习惯性地把真实回归归因为"只是不稳定"。测试套件本该提供的信心信号,从此不再可信。
加超时让套件变慢,却不动根因。 把一条手势超时从 3 秒延长到 8 秒,确实能覆盖"模拟器需要更多时间处理手势事件"的情形,但它也给这条用例的每一次运行加了 5 秒。一个 200 条用例、每条多出 3 秒超时缓冲的套件,整体要多跑 10 分钟。反馈周期变长意味着开发者发现失败时已经切到下一个任务了。
隔离把问题推迟到一个永远不会到来的将来。 “下个迭代再修隔离用例"几乎从不发生,因为修它们要先搞清根因,而搞清根因需要环境调查,比写新用例还慢。于是隔离清单越来越长;而那些被隔离的用例代表的是真实的覆盖空洞——回归就藏在那些空洞里。
三种做法的共同问题是一样的:把一个结构性问题当成维护问题来处理。不稳定不是因为团队不够细致,而是因为基于选择器的测试把用例耦合到了 UI 的实现细节上,而这些细节会随着应用演进、系统更新和 CI 环境漂移不断变化。
有工程团队的公开数据是:即便在检测与监控工具上投入巨大,仍有 15–21% 的构建受到不稳定影响。检测与监控能告诉你是哪些用例坏了,但它们不会告诉你为什么移动端特有的失效模式还在源源不断地制造新的坏用例。
到了某个临界点,比例会反转:质量团队一开始是 90% 的时间写用例、10% 维护;债务累积之后变成 10% 写、90% 维护。这种压缩,就是脚本级修复跑步机在团队尺度上的样子。
不依赖任何工具的五条落地动作
在讨论架构级方案之前,有几件事任何团队都可以立刻做,而且能显著减少上述四类失效:
- 每个用例跑在干净的模拟器快照上,或至少按批次重建模拟器,直接消除"运行中途漂移"这一根因;
- 在测试准备阶段预置权限状态(通过启动参数或系统镜像配置),而不是在流程里靠脚本关弹窗;
- 把手势封装成一层抽象,统一在真实渲染状态之后再执行交互,而不是散落各处的硬编码等待常量;
- 为长列表与无限滚动采用"单步滑动 + 等目标出现” 的写法,替代依赖惯性距离的滑动;
- 把设备矩阵分层:日常流水线跑 2–3 个代表性配置,把碎片化验证放到独立的、频率更低但覆盖更广的批次里。
这些动作能把不稳定的总量压下来,但它们改变不了一个事实:只要用例依赖选择器,UI 变化、系统更新、设备差异就还会持续制造新的失效。
架构级的那一步:去掉选择器依赖
基于选择器的模型——用 CSS 选择器、XPath、无障碍 ID 或资源 ID 定位元素——正是移动端用例脆弱的来源。属性一变,用例就坏;系统改变了视图层级的结构方式,用例就坏;一次布局调整把元素挪了 10 像素改变了它的边界,基于点击坐标的用例就坏。
另一种做法是按元素"看起来是什么、做什么"来识别它,而不是按实现属性。一个"提交"按钮之所以可被识别,是因为它写着"提交"、出现在表单的特定位置、并且响应点击。当这个按钮被重新设计、挪了位置、或者换了无障碍 ID,基于视觉的识别仍然能像人类测试者一样认出它。
顺着这个角度回看前面四种失效模式,会发现它们的根都在选择器模型上:
- 模拟器漂移导致手势事件落在错误元素上,因为元素位置在劣化的模拟器状态里发生了变化——按外观识别,就不依赖坐标;
- 手势时序问题在使用硬编码时间常量时被放大——先观测实际渲染状态再交互,就消除了时序假设;
- 系统权限弹窗之所以打断基于选择器的流程,是因为脚本在找一条已经被遮挡的元素路径——按视觉对象识别并关闭弹窗,不必为每个系统版本的弹窗格式改脚本;
- 设备碎片化会破坏基于选择器的用例,因为布局在不同设备上渲染不同——按"用户看到的样子"识别,就能自动适配布局差异。
需要说明的是,这并不是一个能"装"到现有 Appium 或 Detox 套件上的功能,而是一种不同的测试执行架构:用例验证的用户流程不变,但不再依赖那些让流程难以维护的实现细节。
评估这种转变时,正确的提问不是"它能不能消除全部不稳定"——答案是不能,网络故障和真实的环境问题依然会产生失败。真正的问题是:由 UI 变化、设备碎片化和选择器脆弱性造成的不稳定(也就是移动端特有不稳定中的大多数),从此变成一件在架构层修一次的事,还是继续作为每个迭代都要交的维护税。
结语
这个循环是可预测的:不稳定出现 → 加自动重试 → 超时变长 → 套件变慢 → 信任流失 → 团队不再把 CI 变红当作值得调查的信号。这不是纪律失败,而是把 Web 测试的假设套用到移动端测试问题上的必然结果。
移动端 E2E 的失败原因,在 Web 自动化里根本不存在。模拟器漂移、手势时序、系统弹窗、设备碎片化,都是移动端特有的问题,需要移动端特有的结构性解法,而不是更多层脚本级补丁。
而维护跑步机没有可持续的配速,它只有一个出口。