测试自动化通常被当成一个框架问题来讨论。但当数千个仓库都要跑自己的套件时,问题的性质就变了——它变成了一个基础设施问题。早上九点所有团队同时推送,谁能拿到执行容量?夜间全量回归和阻塞着某个开发者的合入前检查撞在一起时,谁先跑?当相当一部分失败并不是真实缺陷时,又凭什么判定一个版本"已认证"?
有一类平台正是从这种压力里长出来的:它不负责帮你写测试,而是提供一套共享的执行与认证基础设施。本文拆解这类平台的架构、关键策略与真实取舍,数据来自一个在四个 Amazon EKS 集群上、每天执行约 25 万次自动化测试、服务大型金融机构全部工程仓库的实例。
先看清工作负载的五个特征
设计之前必须先承认,测试执行负载有几条会击穿朴素设计的性质:
极端突发。 工作时段和版本发布窗口需求陡增,其余时间容量闲置,永远在"不够"和"浪费"之间摇摆。
紧急度混合。 合入前检查牵着一个工程师的时间,夜间全量回归不牵任何人,但两者抢的是同一批资源,延迟要求却完全不同。
租户异构。 不同团队带来不同的运行时、浏览器栈和数据依赖;一个没有资源约束的套件可以饿死其他所有套件。
信号不可信。 经验研究表明,异步等待、并发、测试顺序依赖会持续产生不稳定(flaky)结果。公开的工程经验里,约 1.5% 的测试运行产生过 flaky 结果,近 16% 的测试表现出某种程度的不稳定。把这个比例放到每天 25 万次执行上,1.5% 就是约 3750 条误导性结果——如果重试、分类与隔离不是平台级策略,而是各团队自选动作,那么"红灯"将彻底失去意义。
审计要求。 在受监管环境里,“这个版本通过了认证"必须能从记录中复现,而不是凭记忆。
三个 Kubernetes 原语撑起大部分设计
这类平台通常只依赖 Kubernetes 的少数几个能力:
- Job 的 Indexed 完成模式:每个 Pod 拿到一个稳定索引,天然映射到测试分片;
- PriorityClass:高优先级 Pod 无法调度时,可以抢占低优先级 Pod;
- ResourceQuota 与 LimitRange:限制命名空间能消耗多少资源,并设置默认请求值,避免共享集群上出现无边界的容器。
在此之上,Kueue 这类队列管理器提供队列级配额,决定一个作业是等待、准入还是被抢占;Karpenter 这类扩容器则为无法调度的 Pod 直接供应节点。
架构:控制平面、执行平面、结果平面
平台把"决定跑什么”(控制平面)、“真正去跑”(执行平面)和"把执行变成决策"(结果平面)三者分开。
控制平面、执行平面与结果平面分离,三者必须作为一个系统建设
提交。 各团队的 CI 系统触发一次运行,声明套件、目标环境和紧急度分类。团队始终不直接接触 Kubernetes——提交 API 才是契约,这样执行细节可以更换而不影响调用方。
准入与排队。 每个租户一个命名空间,配一份配额和一个本地队列。队列管理器在配额可用前挂起工作负载,并在一个 cohort(容量池)内做抢占与公平共享:某团队借走的空闲容量,在另一个团队需要自己份额时可以被回收。借用上限则防止单个租户在发布冲刺期吞掉整个池子。
分片规划。 大套件被切成多个分片,用 Indexed Job 执行,分片索引通过环境变量暴露给 runner——与 Bazel 的 TEST_TOTAL_SHARDS / TEST_SHARD_INDEX 是同一套契约。
执行平面。 四个 EKS 集群承载平台的 40 个应用与大量临时测试 Pod。多集群用更高的控制平面与工具链成本,换取隔离性和更小的爆炸半径——这是多租户设计里被明确记录过的取舍。放置策略需要刻意设计:给每个租户一个"主集群",上面保持镜像缓存与测试数据是热的;当主集群排队时间超过阈值时,由控制平面把整个运行溢出到另一个集群,而不是把一次运行拆到多个集群——拆分会让结果收集和基础设施故障定位变得极难。
结果与认证。 每个分片把结构化结果消息发给报告与洞察服务,由它判定每个套件的通过/失败、识别 flake、并在发布上登记一个认证结论。整个平台里最重要的契约就是这条事件 schema:
| |
failureCause(test / environment / platform)与 attempt 是让结果层区分"flaky 测试"与"丢了一个节点"的关键,也是把基础设施故障记到平台账上而不是团队账上的依据。
配置长什么样
租户的队列与配额由平台团队声明一次:
| |
cohort 让团队借用空闲容量,reclaimWithinCohort 让所有者把容量收回来,borrowingLimit 阻止任何单一租户在发布冲刺期吸干整个池。
一个分片化套件则是一个普通的带优先级类的 Indexed Job:
| |
几个细节值得照抄:backoffLimitPerIndex 只重试失败的那一个分片,不重跑其余 39 个——某个分片撞上基础设施故障时这非常重要;内存必须设 limit,因为共享节点上一个 OOM 的 runner 会拖累邻居;CPU 在 request 之上不设上限,用于吸收短时突发。
还有一条容易被忽略:分片要按历史执行时长来切,不能按用例数量切。一个套件的完成时间取决于它最慢的那个分片,而不是分片里有多少条用例。
延迟来自三次等待,各有各的杠杆
运行延迟基本由三段等待构成,每一段的优化手段和代价都不同:
| 等待 | 杠杆 | 代价 |
|---|---|---|
| 排队 | 提高名义配额、cohort 借用 | 预留的空闲容量 |
| 节点供给 | 预热缓冲节点、预拉取 runner 镜像 | 为闲置节点付费 |
| 最慢分片 | 按时长分片、更多分片 | 每 Pod 的启动开销 |
扩容器在这类尖峰且多样的需求上表现好,因为它直接按挂起 Pod 的要求供应节点;传统节点组方案在设计得当时依然可用。无论选哪个,都要让 runner 镜像小而可缓存——在这个量级上,镜像拉取时间一天要被支付几万次。
安全:测试代码是"半可信代码"
测试代码会执行仓库提交的任何东西,因此它不能被当作可信负载。实践要点包括:Pod 尽量遵循 Restricted 级别的安全标准;用命名空间 + RBAC 保证某团队的服务账号读不到另一团队的作业;云资源访问走 IAM Roles for Service Accounts 或 EKS Pod Identity,而不是长期密钥;测试凭证放在具备最小权限访问的密钥管理系统里;runner 镜像要扫描并固定版本。在受监管场景里,测试环境还要通过网络策略与生产数据隔离,而不是靠约定。
一次典型故障场景:发布日早晨
三个团队赶在发布截止时间前提交全量回归套件,同时几十位工程师在跑合入前检查。
没有配额时,先提交的回归套件会占满所有可用节点,合入前检查只能排队,整个组织的开发节奏被拖停。有了上面的设计:每个回归套件在团队名义配额加有限借用额度内运行;合入前 Pod 带更高的优先级类,在节点不足时抢占夜间级的工作;扩容器为剩余积压补充容量。结果是回归套件的完成时间比在空集群上更晚,但没有任何单一团队能踩下全局的刹车。这就是共享平台给出的取舍。
权衡与局限,必须提前说清
中心化会造出一个所有人都依赖的团队:它的路线图成了瓶颈,它的一次故障会同时停掉所有发布。多集群降低了爆炸半径,却让升级、插件版本和配置漂移成倍增加。每个团队该分多少,本质是组织问题——调度器不解决这个。
自动重试还会掩盖真正的间歇性问题:生产代码里的竞态,表现和 flaky 测试一模一样。如果一律重试了事,二者永远分不开。
为什么不用 CI 系统自带的并行能力?因为按流水线分配的 runner 一次只服务一个仓库,做不到组织级的公平调度、做不到基础设施失败的统一归因、也产不出单一的认证报告。集中式平台解决的是这几件事,代价是团队自主性。对只有少量仓库的小团队,或者需要特殊硬件、共享池无法常驻保温的作业,它是错误的选择。
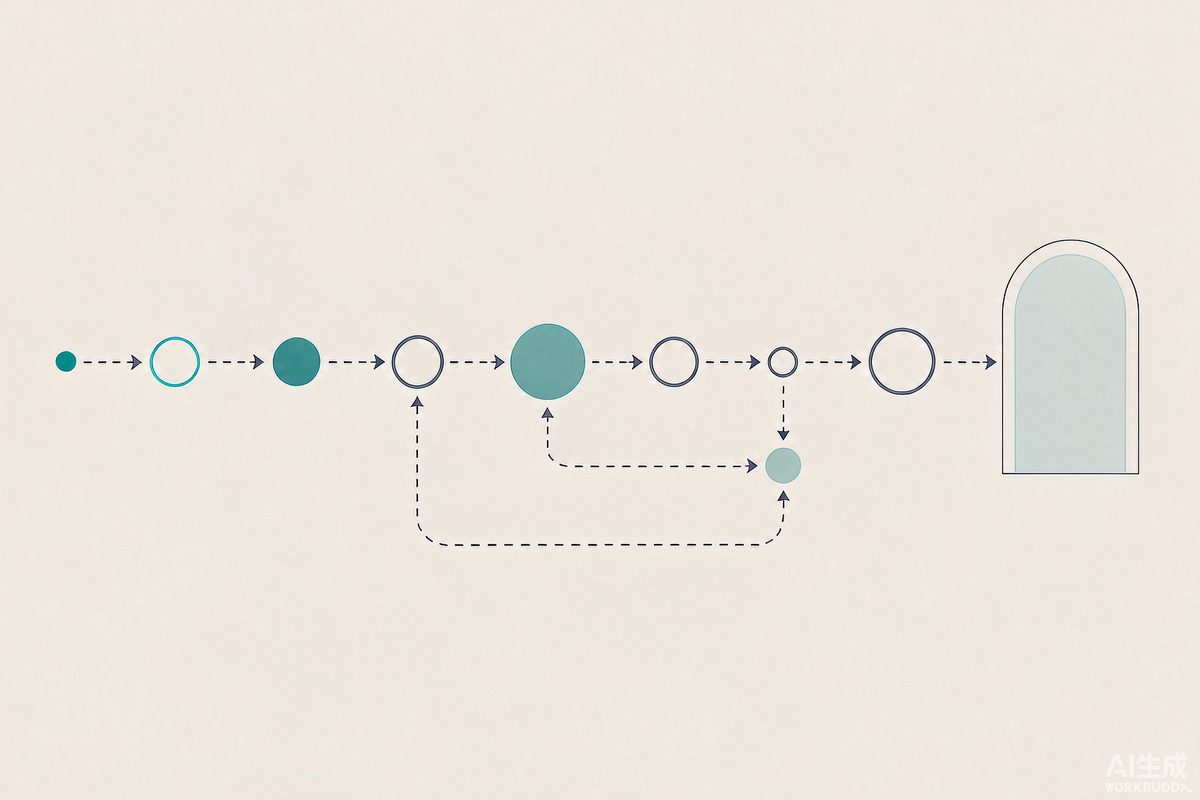
一次运行的生命周期:准入、分片执行、失败分类、单分片重试、隔离后认证
五条来自生产的教训
在源头区分基础设施失败与测试失败。 如果节点被驱逐和断言失败产出的是同一种红色,团队会迅速不再信任平台。runner 应当把失败原因作为一等字段上报:test、environment 还是 platform。
重试一次,换一个 Pod,并且记录下来。 在不同基础设施上重试一次,可以把环境噪声和确定性失败分开。静默的、反复的重试只会抬高成本,并把真正的并发缺陷埋掉——而并发正是 flaky 的头号根因。
隔离(quarantine)是一个工作流,不是一个开关。 被隔离的测试必须有责任人、有工单、有到期时间,否则隔离清单会一直变长,直到"认证"两个字失去意义。
报告层就是产品本身。 团队是通过结果视图来评价平台的,而不是通过调度器。报告与洞察服务值得一支专门的工程队伍,而不是被当作附属功能。
入职培训也是平台的一部分。 当所有仓库都依赖同一个执行平台时,误用——无边界的套件、缺失资源声明、测试代码里自带重试循环——成本由所有人承担。给新人做持续交付 onboarding,在效果上和任何一条配额一样是平台控制手段。
可以直接照搬的最佳实践
- 暴露稳定的提交 API,绝不让租户依赖集群内部细节;
- 从第一天起就给每个租户配额、队列和默认资源限制;
- 按历史时长分片;按分片重试,绝不按整个套件重试;
- 公布每个套件的 flake 率,并对每次运行做端到端追踪。
可观测性要建在平台层面,而不只是测试层面:一次运行从提交、准入、调度到结果 ingest 全程埋点,“我的这次运行为什么慢"要能按阶段给出答案。核心服务级别指标是四个:准入时间、首个结果返回时间、基础设施失败率(与测试失败率分开统计)、以及每个套件的 flake 率。交付成效可以用 DORA 指标跟踪,看平台是否真的缩短了前置时间、降低了变更失败率。
接下来最值钱的两个方向
一个是基于变更的测试选择。公开数据表明绝大多数测试极少失败,因此"跑哪些"仍然是最大的成本杠杆。另一个是 AI 辅助分诊:它可以按可能原因给失败聚类,但它应该辅助责任人,而不是自动隔离测试——误分类会直接削弱认证的可信度。
结论可以浓缩成一句:集中式测试编排平台做的事不只是调度。它还安全地隔离租户,并提供质量的权威记录。Kubernetes 提供了好用的原语——Indexed Job、优先级、配额、队列管理器——但真正决定价值的是策略:哪些团队拿到容量、失败如何归类、什么才算"已认证”。队列、失败分类法和报告层必须作为一个系统来建设,三者中任何一个不可信,其余两个也不可信。