有一条在安全关键领域被反复验证过的规则:构建系统的人,绝不能是验证这个系统的人。它不是流程上的繁文缛节,而是验证有效性的前提——一个人按自己的理解实现,再按自己的理解去验证,两处理解天然一致,验证就退化成了自我确认。
当编码工作由 AI 代理完成时,这条规则遇到了一个新情况:同一个模型既能写代码,也能写测试,还能给出"测试全部通过"的结论。于是出现了一个值得认真对待的问题——有没有办法在机器流水线里,把这条规则强制执行,而不只是写在规范里。
把一份规格拆成两半
有一种做法是把规格文件拆成两部分:需求(requirements)与验收标准(acceptance criteria)。编码代理只拿到需求部分,验收标准在它被 handed 文件之前就被切掉;另一个独立的测试代理则只依据验收标准写测试,并且不读实现代码。
两个代理运行在同一条流水线里,但看到的信息不重叠:
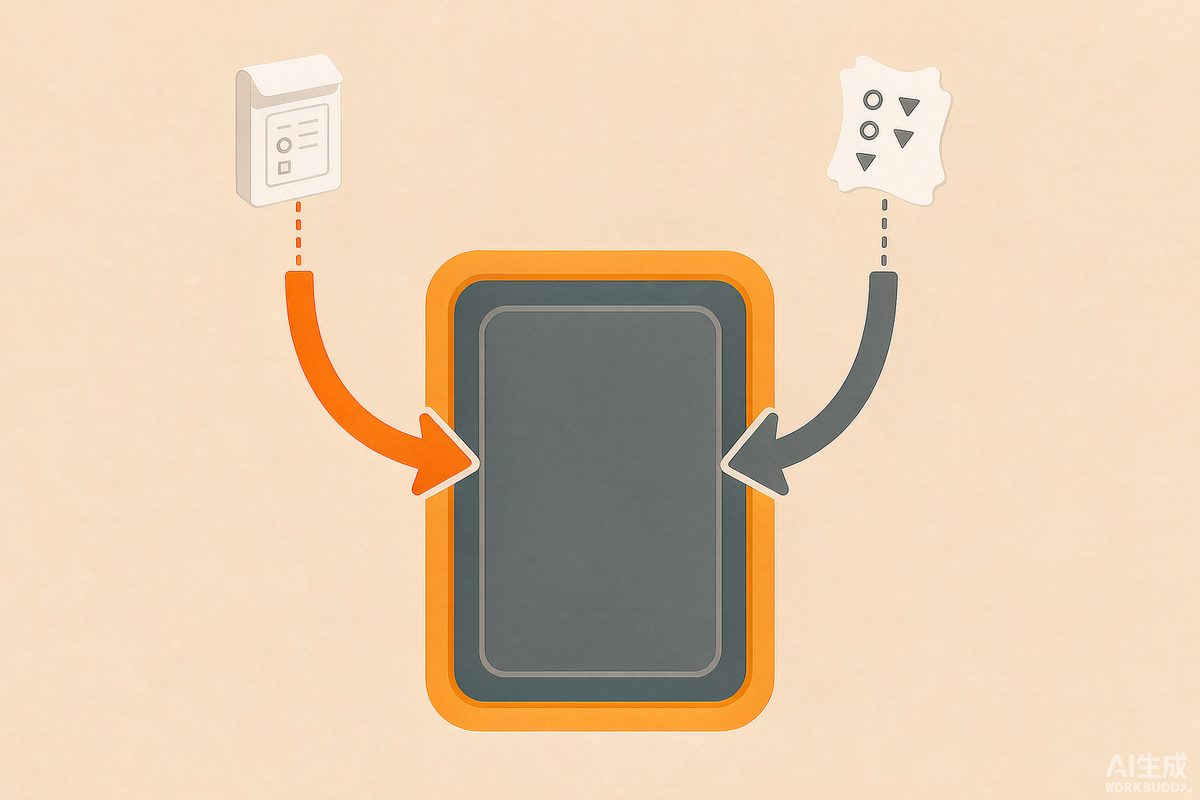
两条信息通道互不重叠,只在测试失败信息处交汇
- 编码代理:需求 + 测试数据,看不到验收标准;
- 测试代理:需求 + 验收标准 + 测试数据,看不到实现;
- 二者唯一交汇的地方,是测试运行后返回的失败信息。
关键在于"切掉"这一步是在代码里完成的,而不是靠提示词请求模型自觉。它是一个可以被演示、可以被审计的流水线属性,而不是一个承诺。
一次完整运行:失败信息只给一行
看一次真实运行的片段,比描述有用。
任务是:读取记录的雷达采样,剔除无效样本,计算与前车的时距(time headway),并在时距低于两秒时告警。编码代理只依据需求,写出了这样的范围检查——保留了上限,却放过了间距为零的情况:
| |
而测试夹具 CSV 里有一行 S005,是一段间距恰好为 0 米的雷达采样。由验收标准生成的测试要求这一行被剔除,结果没有:
| |
这就是编码代理得到的全部反馈:哪个测试失败、测试断言了什么,没有任何关于背后规则的提示。模型从中推断出——间距恰为零不是一次有效测量。
随后它产出了一个 PATCH,改动一个字符:
| |
从写测试到各阶段套件全绿,整轮运行不到一分钟,模型调用不到十次,成本是几分之一美分。但真正值得关注的不是速度,而是因果:代理收紧下界,是因为一个它从未见过的测试把 0 米间距放进了"必须剔除"的那一堆,而不是因为某条书面标准告诉它零是无效的。
如果它当初直接看到了那条标准,它会在第一次尝试时就写出正确的检查,套件也会第一次就通过——而那个"绿色"结果什么都证明不了,就像一个学生给自己出的卷子考了满分。
最容易犯的错:把决策藏进验收标准
上面这次运行其实来自任务的第二版。第一版暴露的问题更值得记录,因为从外面看,它很像"改规格改到通过为止"。
第一版的需求只说:当时距违反"两秒规则"时告警。而"时距恰好为 2.00 秒是否告警"这个问题,被放在了隐藏的验收标准里:
| |
回到那个判断标准:只给定需求,两个合格的开发者会不会对 2.00 秒有不同理解?很容易。“违反两秒规则"既可以读成"低于”,也可以读成"不高于"。这就是一个决策,而一个藏在测试标准里的决策,正是这种拆分要避免的错误。
第一批运行显示了代价:十个随机种子里只有三个收敛。另外七个,负责写测试的代理把歧义解析错了,写出了一个在恰好 2.00 秒时告警的测试——这与它自己拿到的那条验收标准相矛盾。这一点值得停下来想:测试代理同时拿着模糊的需求和清晰的验收标准,仍然写错了方向。一条松到两种读法都成立的需求,不只是让编码者猜测,它还会把测试编写者从它被给定的标准上拽开。而任何实现都不可能通过一个与自己标准相矛盾的测试。
正确的修法只移动决策本身,并且只移动决策。验收标准保留了由这个决策推出的全部后果,速度与间距的其他限制一字未动,包括"间距为零必须剔除"这条。没有削弱任何东西,也没有删掉任何东西。
移动这一句话之后,同样十个种子在第一轮扫描里十次全部收敛;上文那个零间距的修复仍在其中七次发生,依旧是被一个编码代理从未见过的测试抓出来的。
修规格与降标准的界线
这里有一条很细但很重要的界线。
移动一个编码者需要的决策,是规格本来就欠着的修正,而且它单靠"两个合格开发者会不会分歧"这个问题就能自证,不需要看任何代码。而删除那条标准、放宽它、或者把它的边界值抄进需求,同样能让运行通过——但那样什么都证明不了。
这条界线在 AI 时代尤其危险,因为"让它变绿"的成本被压到了一次对话。当测试不通过时,代理最省力的选择往往是改动测试或标准,而不是改动实现。流水线里必须有一条硬规则:不通过时,允许改实现、允许改需求表述,不允许放宽验收标准。工具在这一环的做法是——运行不收敛就非零退出、点名列出阻塞它的测试、并且什么都不交付。
代码已经存在时,什么变了
上面所有内容都假设实现是在本次运行中写出来的,这也是唯一能真正强制隔离的情形:同一个进程同时驱动两个代理,验收标准在一侧的提示词里被代码剥离。
但现实中的大多数代码不是这样。它早就存在,几个月前由人或由助手写成,团队想要的是"把这段代码检查一遍"。
同样的双代理工作流也可以指向既有代码,测试套件仍然由从未读过实现的代理依据标准生成。变的是每种结果的分量:
| 结果 | 运行中写出的代码 | 已经存在的代码 |
|---|---|---|
| 测试失败 | 真实发现 | 仍然是真实发现 |
| 测试通过 | 代码满足了它从未见过的一条标准 | 代码与一条其作者可能看过的标准一致 |
失败在两种情形下都可靠,因为测试是依据标准写的、没有读过实现,不一致就是代码与规格之间的真实分歧。只有"通过"会变弱,而且变弱的原因与工具无关:写那段代码的人,当时可能把验收标准开在旁边的窗口里。
这是一个关于时间线的论断,所以值得把它画清楚。对既有代码,事后无法强制验证顺序,唯一能问的是版本控制——它一直在记笔记:
| |
现在针对既有代码的一次运行会问的正是这个问题,并且把答案连同它的边界一起打印出来——因为边界本身就是真相的大部分。提交日期不等于写作日期:代码可以在工作区里躺上几周不提交,所以这个顺序缩小了"标准是从代码反推出来的"这一风险,但没有消除它;而标准先提交,也完全不能说明开发者实现之前是否被允许读过它。
因此,这份证据在结果不好时最有价值:标准在代码落地之后被修订过,是一个应该有人去回答的问题。这种不对称与上表一致——宁可交付一个明确说明自己局限的检查,也不要打印一个绿色对勾,让读者以为它证明了更多。
版本控制确实知道、并且能明确说出一件事:两边分别是谁提交的。两个不同的人,正是整套方法所借用的职责分离。
967 次运行给出的数字
目前的证据是这样:在工具自带的示例任务上,三批合计 967 次运行(使用一个小而便宜的模型,以便这些扫描能被负担得起地重复),大约八成的运行产出的代码能通过全部集成与系统测试,大约六成能通过包括单元测试在内的全部阶段。在流程加固、并在两处把任务变得更难之后,第四批 390 次运行复现了同样的两个数字。
这个数字是单独列出的,而不是与前几批合并——用一个数字描述两套不同的系统,正是结果日后被撤回的方式。另外,这些运行用的是便宜模型,因此这两个比例应当被读作性能下限。
两个阶段之间的差距主要来自单元测试:它最后执行,也最严格。剩下的问题大多可以用两个问题覆盖:
- 如果每一轮迭代产出的 FIX 和 PATCH 几乎一模一样,说明代理在猜一个没人告诉它的决策——问题在规格;
- 如果某条规则在你的样本数据里根本触发不了,你就会得到一个无论代码怎么写都通过的测试——问题在数据,不在代码。
边缘用例与实验设计:为什么"平均值通过"是假象
职责分离这条法则在量产辅助驾驶项目里的具体形态,是边缘用例。有一类反复出现的问题:感知模块满足了需求——按开发者自己理解的方式——却没达到真正要测的东西。
一条检测精度需求会规定系统必须维持在某个界限内。实现团队把它读成"一次记录行驶全程的平均精度",这在边做边看的时候是很自然的解读,他们自己的测试也与这个解读一致。而独立团队依据需求本身(而非开发者的解读)对同一批数据做真值(Ground Truth)比对,暴露出的失效是全程平均精度永远揭示不了的。
比如验收标准会问:在每一帧上是否都成立?包括那几帧——有车辆从传感器视野边缘切入,或者发生了某种遮挡。按行驶全程平均,这类模块轻松通过;逐帧看则不然,因为几千个简单帧会把决定系统是否安全的那几十帧淹没。需求从来没有说明这个界限是均值还是最坏情况,实现者挑了自己代码自然产生的那种读法,并且诚实地按这个读法自行验证。开发者通常没有时间和资源去亲自核对所有边缘用例,往往会挑几个重要场景验证就转向下一个任务。
这就是运行设计域(ODD)问题。在复杂系统里准确、完备地定义边缘用例,工作量极大。参数组合多到采用暴力覆盖在实践上不可行,只有理想预言(oracle)才能在全部场景上生成完美覆盖。因此需要遵循实验设计(DOE)原则,在整个测试空间上以最优方式覆盖 ODD。
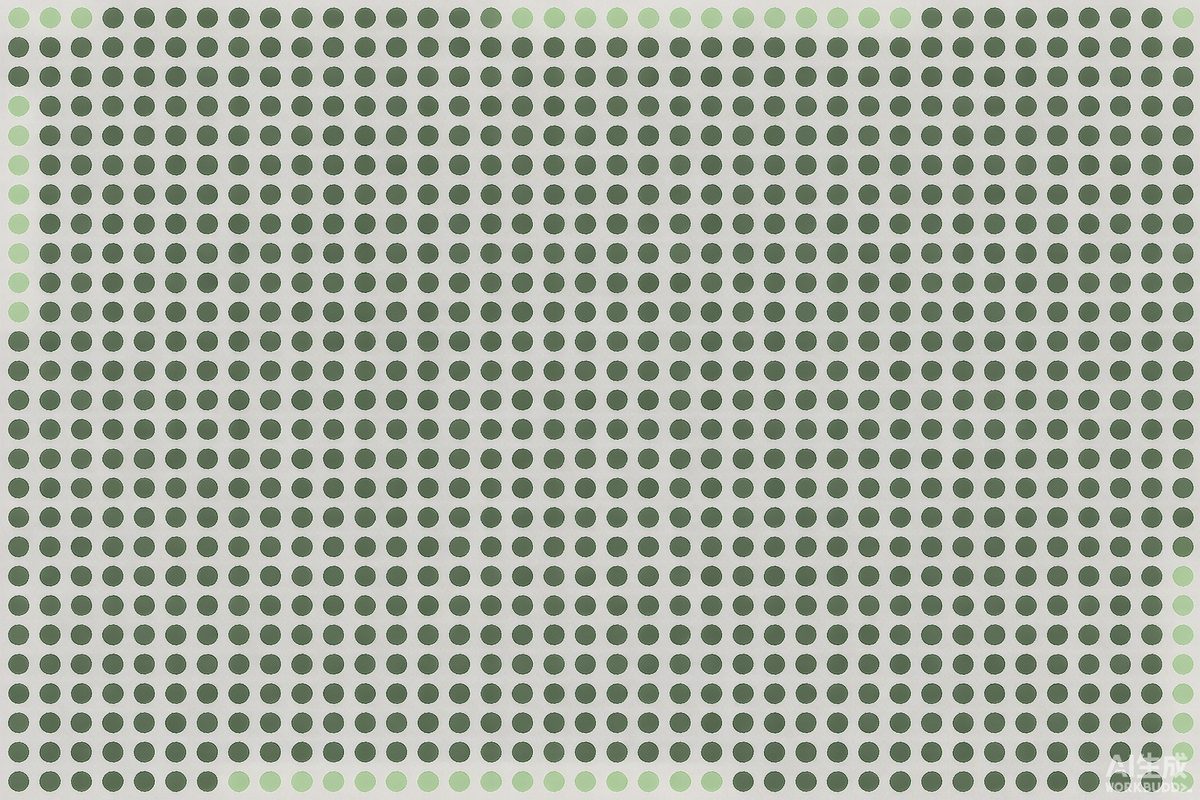
样本数据在空间中分布均匀,稀有边缘区域却几乎没有覆盖点
同样的问题在这个工具里以缩小的规模重现了一次:为了衡量"更清晰的标准是否能抓到更多故障"而植入的故障,绝大多数对任何测试套件都不可见——因为验收标准描述的那些输入,在夹具数据里从来不存在。一条没有任何东西能触发的标准,不是一条标准。 如果测试行驶数据里从不包括暴雨,那么无论测试团队多优秀,都学不到任何关于暴雨的东西。
Validation 仍然需要人在回路
有一点必须说清楚:以上全部内容都属于验证(verification)——给定一份书面标准,代码是否满足它,并且由构建时看不到标准的一方来检查。它一点都没有触及确认(validation):这份标准本身是否描述了应该发生的事。
工具可以强制一个编码代理永远看不到验收标准。没有任何工具能告诉你,那些标准是不是该写的那几条。就目前而言,这仍然需要一个理解领域、理解用户、理解系统究竟为何而存在的人。它也要求把"正确行为"写成具体、可检查的描述,包括那些粗心的读法会漏掉的边缘用例。AI 当然也能辅助这一切,但它依然需要人类专家来监督、批准规格,并在规格演化过程中保持在回路里。
可以立刻借鉴的三件事
第一,把"决策"和"后果"在规格里分开写。凡是两个合格开发者会产生分歧的表述,都属于必须在需求侧就定死的决策;验收标准只保留由该决策推出的可检查后果。判断方法很简单:读一遍需求,问自己是否存在两种合理读法。
第二,给流水线加一条硬约束——运行不收敛时不允许放宽标准。允许修改实现、允许澄清需求,但把"删除或放宽一条验收标准"变成需要人工审批的动作。没有这条约束,代理总会选最省力的那条路。
第三,检查你的测试数据能否触发每一条规则。写一条标准时同步问一句:样本里有哪一行数据会让它失败?找不到答案的标准,等于没有标准。
更根本的一点是,验证与确认并不是流程里的两个步骤,而是一种关于"谁有权回答哪个问题、以及为什么"的职业心智。值得警惕的不是信任本身,而是方法论层面的疏漏:由构建者执行的检查,不是真正的检查。无论构建者是赶工期的人,还是一个有上下文窗口和预算限制的 LLM,这一点都成立,并且在下一代软件的开发中依然成立。